

روزانه میلیاردها جستجو در بستر گوگل توسط کاربران سراسر جهان ثبت میشود تا در کسری از ثانیه پاسخ پرسشها، مشخصات کالاها و خدمات مورد نیاز در صفحه نتایج جستجو پدیدار شوند. این فرآیند سریع، حاصل فعالیت یکی از گستردهترین زیرساختهای پردازش ابری در تاریخ مهندسی نرمافزار است. درک عمیق از نحوه کار موتور جستجو برای هر مدیر سایت، کارشناس دیجیتال مارکتینگ و سئوکار یک ضرورت بنیادین به شمار میرود، زیرا بهینهسازی بدون شناخت سازوکار خزندهها به هدررفت منابع میانجامد.
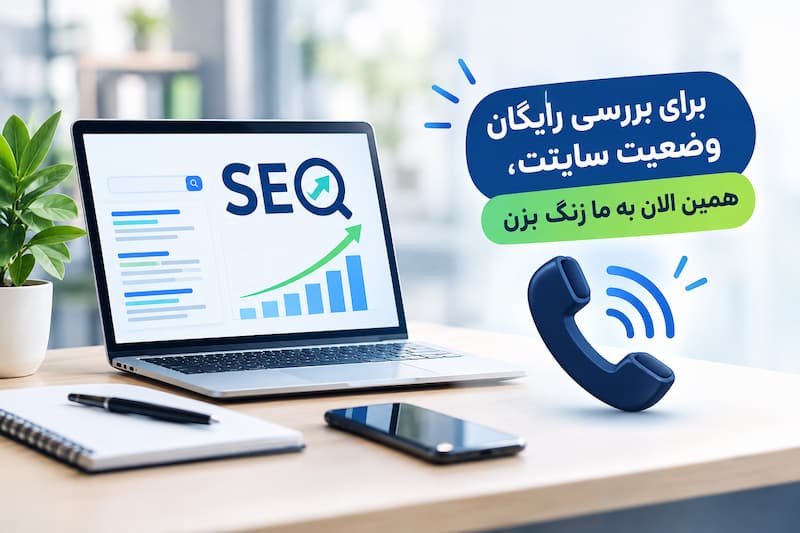
بسیاری از پلتفرمهای اینترنتی با وجود صرف هزینههای سنگین در بخشهای گرافیکی و تولید صدها صفحه، سهمی از رتبههای برتر به دست نمیآورند؛ چرا که ساختار فنی آنها خزش و فهم دادهها را برای رباتها با مانع روبهرو ساخته است. طبق مستندات رسمی Google Search Central در راهنمای جامع سازوکار جستجو، عملکرد هر موتور جستجو حاصل تعامل نظاممند سه مرحله متوالی است: کشف نشانیها از طریق خزش، پردازش و ذخیرهسازی دادهها در فاز نمایهسازی، و انتخاب بهترین پاسخها در مرحله رتبهبندی. در این راهنمای تخصصی، تمامی جزئیات فنی، لاگهای خزش، وضعیتهای سرچ کنسول و الگوریتمهای هوش مصنوعی را کالبدشکافی خواهیم کرد.
فهرست مطالب
- سه مرحله بنیادین در عملکرد موتورهای جستجو
- مشاوره تخصصی سئو
- برای بررسی رایگان وضعیت سایتت، همین الان به ما زنگ بزن
- فاز اول: فرآیند خزش (Crawling) و معماری Googlebot
- بودجه خزش (Crawl Budget) و متغیرهای تعیینکننده آن
- تاثیر ریدایرکتها بر بودجه خزش طبق مستندات گوگل
- فایل Robots.txt و راهنمای کدهای وضعیت پاسخ سرور (HTTP Status Codes)
- فاز دوم: ایندکس یا نمایهسازی (Indexing) و ذخیره دادهها
- چالشهای رندرینگ جاوااسکریپت در وب مدرن
- تحلیل وضعیتهای متداول بخش Page Indexing در سرچ کنسول
- نقشه سایت (XML Sitemap) و کنترل مسیرهای خزش
- متاتگهای استاندارد رباتها در سطح کد HTML
- مشاوره تخصصی سئو
- اگر برای اجرای این مراحل به کمک نیاز داری، تیم سئو ترافیک کنارته
- فاز سوم: رتبهبندی (Ranking) و هوش مصنوعی موتور جستجو
- نقش نیت جستجو (Search Intent) در جلب رضایت کاربر
- سیستمهای هوش مصنوعی نوین در هسته الگوریتمهای گوگل
- جدول مقایسهای سه فاز خزش، ایندکس و رتبهبندی
- تحلیل لاگ سرور (Log File Analysis)؛ مشاهده ردپای واقعی خزندهها
- بهینهسازی معماری فنی سایت برای تسریع فرآیند ایندکس
- نتیجهگیری و توصیههای راهبردی
- پرسشهای متداول درباره نحوه کار موتور جستجو
سه مرحله بنیادین در عملکرد موتورهای جستجو
نخستین نکته فنی که باید مد نظر قرار گیرد این است که هنگام تایپ یک پرسش در باکس جستجو، گوگل تمام وب زنده را در همان لحظه اسکن نمیکند؛ بلکه در کپیهای سازمانیافتهای که پیشتر در پایگاه داده ابری خود ذخیره کرده، جستجو انجام میدهد. این سازوکار از سه فاز مستقل اما پیوسته تشکیل شده است:
در فاز خزش، برنامههای خودکار موسوم به خزنده به دنبال یافتن صفحات جدید یا بازبینی محتواهای قبلی میروند؛ در فاز نمایهسازی، اسناد دانلودشده رندر، کدگشایی و در فهرست معکوس طبقهبندی میشوند؛ و در فاز رتبهبندی، سامانههای هوش مصنوعی مناسبترین پاسخها را بر اساس سیگنالهای رضایت کاربر به نمایش میگذارند. درک این زنجیره پیشنیاز هرگونه فعالیت بازاریابی ارگانیک است؛ زیرا آگاهی از اینکه سئو چیست و چگونه وبسایت را با این ساختار هماهنگ میکند، سنگ بنای تسخیر رتبههای سرچ خواهد بود.
فاز اول: فرآیند خزش (Crawling) و معماری Googlebot
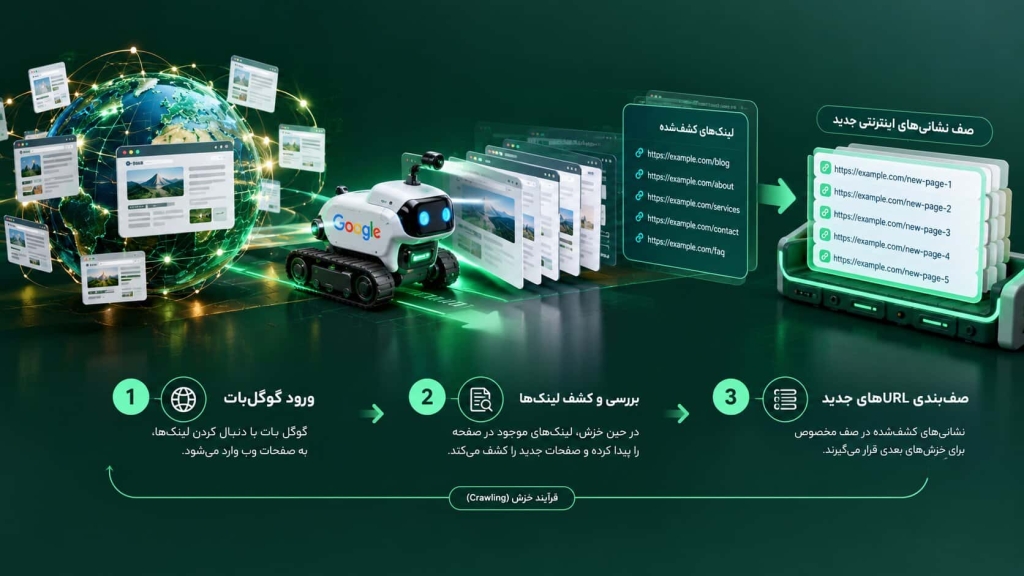
خزش دروازه ورود هر سند به جهان جستجو است. در این فرآیند، خزندههای خودکار به صورت پیوسته آدرسهای وب را دانلود و لینکهای موجود در آنها را ردیابی میکنند. نرمافزار خزشگر اختصاصی گوگل تحت عنوان Googlebot فعالیت میکند که دارای دو فرمت عملیاتی دسکتاپ و گوشیهای هوشمند بر پایه اولویت خزش موبایل (Mobile-First Indexing) است.
فرآیند کشف لینکها بر یک فهرست پویا از نشانیهای اینترنتی شناختهشده استوار است. هنگامی که خزنده به یک صفحه وارد میشود، فایل HTML و منابع متصل به آن را بارگیری کرده و تگهای پیوند معتبر را استخراج میکند. این آدرسهای تازه استخراجشده درون یک مخزن سازمانیافته تحت عنوان صف خزش (Crawl Queue) قرار میگیرند تا براساس اولویتها و منابع سرور مورد پیمایش قرار گیرند.
بودجه خزش (Crawl Budget) و متغیرهای تعیینکننده آن
موتورهای جستجو با وجود در اختیار داشتن دیتاسنترهای عظیم ابری، منابع پردازشی و پهنای باند محدودی را به هر دامنه اختصاص میدهند تا فشار بیش از حد به سرورهای میزبان وارد نشود. به تعداد صفحاتی که گوگلبات در یک بازه زمانی معین حاضر است و میتواند در یک سایت خزش کند، بودجه خزش گفته میشود. این متغیر از تلفیق دو عامل اصلی شکل میگیرد: محدودیت نرخ خزش (Crawl Rate Limit) که وابسته به سرعت و کشش سرور است، و تقاضای خزش (Crawl Demand) که براساس محبوبیت، تازگی محتوا و دفعات بهروزرسانی تعیین میشود.
اگر پلتفرم شما دارای زنجیرههای طولانی ریدایرکت، صفحات خطای متعدد، کدهای کند یا هزاران آدرس بیکیفیت و تکراری حاصل از فیلترهای فروشگاهی باشد، بودجه خزش تلف میشود. در چنین شرایطی ممکن است صفحات تجاری تازه انتشار یافته تا هفتهها توسط خزندهها ویزیت نشوند.
تاثیر ریدایرکتها بر بودجه خزش طبق مستندات گوگل
ریدایرکتهای زنجیرهای یکی از بزرگترین عوامل هدررفت بودجه خزش هستند. هنگامی که نشانی الف به نشانی ب، و سپس نشانی ب به نشانی ج منتقل میشود، گوگلبات برای دیدن محتوای نهایی ناچار به ارسال چندین درخواست HTTP پیدرپی است. طبق مستندات رسمی Google Search Central، خزندههای گوگل برای صفحات وب حداکثر تا ۱۰ مرحله ریدایرکت متوالی را دنبال میکنند و پس از آن فرآیند خزش متوقف شده و خطای انتقال ثبت میگردد (در حالی که این آستانه برای فایل robots.txt حداکثر ۵ مرحله است). با این حال، حتی وجود ۲ یا ۳ مرحله ریدایرکت نیز سرعت ایندکس را کند کرده و منابع سرور را هدر میدهد؛ به همین دلیل پیوند دادن مستقیم به آدرس نهایی یک الزام بهینهسازی فنی است.
فایل Robots.txt و راهنمای کدهای وضعیت پاسخ سرور (HTTP Status Codes)
فایل Robots.txt سندی متنی در ریشه سایت است که قوانین دسترسی رباتها را مشخص میکند. با بهرهگیری از دستور Disallow میتوان بخشهای زائد نظیر پنل مدیریت و فیلترهای جستجوی داخلی را مسدود کرد. همزمان، کدهای پاسخ سرور نقشی تعیینکننده در رفتار خزنده دارند:
- کدهای وضعیت ۲۰۰ (OK): بیانگر دسترسی سالم به محتوا برای خزش و پردازش است.
- کدهای وضعیت ۳۰۱ و ۳۰۲ (Redirect): مسیر تغییر نشانی دائم یا موقت را نشان میدهند و صف خزش را بهروزرسانی میکنند.
- کدهای وضعیت ۴۰۴ و ۴۱۰ (Not Found / Gone): به خزندهها اعلام میکنند که سند وجود ندارد یا برای همیشه حذف شده است تا از صف خزش دورهای خارج شود.
- کدهای وضعیت ۵۰۰ و ۵۰۳ (Server Error): هشداری جدی از ناتوانی سرور هستند که گوگلبات را وادار به کاهش شدید نرخ خزش و تعلیق بررسی صفحات میکنند.
فاز دوم: ایندکس یا نمایهسازی (Indexing) و ذخیره دادهها
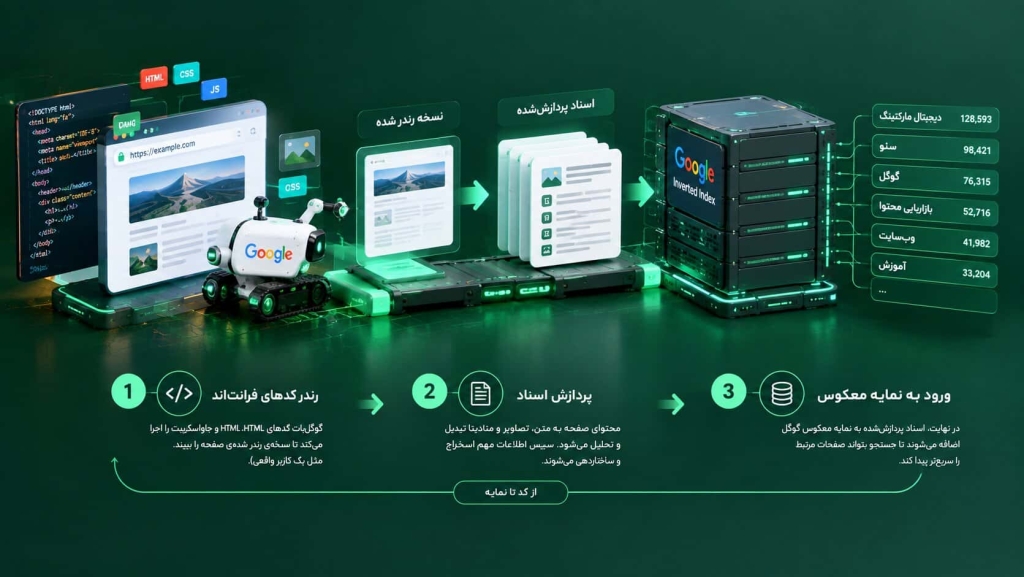
پس از اتمام فرآیند دانلود اسناد، مرحله دوم یعنی نمایهسازی آغاز میشود. در این فاز، گوگل تلاش میکند محتوا، زبان، هدف و ساختار معنایی صفحه را متوجه شود. فرآیند ایندکس شامل تحلیل متن بدنه، استخراج عناوین، خواندن ویژگیهای متن جایگزین تصاویر، بررسی ساختار دادههای نشانهگذاری و ارزیابی تگهای هدینگ است.
دادههای تحلیلشده پس از پردازش، در پایگاهی توزیعشده به نام فهرست معکوس (Inverted Index) ذخیره میشوند. در فهرست معکوس، به ازای هر کلمه یا مفهوم، لیستی از کلیه آدرسهای وب حاوی آن مفهوم همراه با مختصات قرارگیری کلمات ثبت میگردد تا در زمان سرچ، امکان فراخوانی آنی در چند میلیثانیه فراهم باشد
چالشهای رندرینگ جاوااسکریپت در وب مدرن
گوگلبات برای مشاهده محتوایی که کاربران انسانی در مرورگر میبینند، از سرویس رندر وب (Web Rendering Service) بهره میبرد. موتور جستجو فایلهای HTML را پردازش کرده و کدهای استایل و اسکریپتها را اجرا میکند تا صفحه نهایی را اصطلاحاً نقاشی کند. اما اجرای جاوااسکریپت از نظر توان محاسباتی فرآیندی سنگین است؛ بنابراین گوگل ابتدا محتوای متنی موجود در HTML خام را میخواند و رندرینگ عمیق اسکریپتها را به صف رندر دوم موکول میکند.
اگر متون اصلی و لینکهای ناوبری شما وابسته به اجرای کدهای فرانتاند در مرورگر باشد، ممکن است با تاخیرهای طولانی در نمایهسازی مواجه شوید. به همین سبب، بررسی فنی و گزینش آگاهانه میان وردپرس یا کدنویسی اختصاصی از نظر قابلیتهای رندر سمت سرور (SSR) نقش تعیینکنندهای در تضمین نمایهسازی پایدار صفحات ایفا میکند.
تحلیل وضعیتهای متداول بخش Page Indexing در سرچ کنسول
گزارش پوشش ایندکس در گوگل سرچ کنسول مهمترین آینه سلامت وضعیت دسترسی صفحات است. پیامهای این بخش در واقع وضعیت گزارش هستند و شناخت آنها مانع از سردرگمی میشود:
- وضعیت Crawled – currently not indexed: این عبارت به این معناست که صفحه توسط گوگل خزش شده، اما موتور جستجو تصمیم گرفته فعلاً آن را در نمایه ذخیره نکند. این تصمیم معمولاً به دلیل ارزش محتوایی ناکافی، کیفیت پایین یا شباهت زیاد به سایر صفحات سایت اتخاذ میشود.
- وضعیت Discovered – currently not indexed: گوگل آدرس را پیدا کرده و به صف خزش افزوده، اما به دلیل اولویتبندی بودجه خزش یا پاسخ کند سرور هنوز آن را باز نکرده است.
- وضعیت Alternate page with proper canonical tag: صفحاتی که به عنوان نسخه ثانویه شناخته شدهاند و سیگنال کانونیکال آنها به درستی به نسخه اصلی هدایت شده است.
- وضعیت Duplicate without user-selected canonical: وضعیتی که در آن چند صفحه یکسان بدون تعیین تگ کانونیکال توسط مدیر سایت رها شدهاند و گوگل بر اساس حدس خود نسخه اصلی را انتخاب کرده است.
نقشه سایت (XML Sitemap) و کنترل مسیرهای خزش
نقشه سایت به منزله یک فهرست راهنما از باارزشترین نشانیهای وبسایت است که به صورت مستقیم در سرچ کنسول ثبت میشود. نقشه سایت به خزندهها کمک میکند صفحات تازه ایجادشده یا بهروزشده را سریعتر کشف کنند. با این حال، ثبت یک صفحه در سایتمپ هیچ تضمینی برای ایندکس شدن قطعی آن ایجاد نمیکند؛ تصمیم نهایی برای ذخیرهسازی همواره بر پایه ارزیابی کیفیت محتوا و رفتار کاربران گرفته میشود.
متاتگهای استاندارد رباتها در سطح کد HTML
علاوه بر فایل robots.txt، وبمسترها میتوانند از دستورالعملهای متاتگ robots در تگ head صفحات استفاده کنند. برخی از دستورات استاندارد و رسمی عبارتند از:
- دستور noindex: مانع از ورود صفحه به فهرست نتایج جستجو میشود.
- دستور nofollow: به خزندهها اعلام میکند پیوندهای موجود در این صفحه را دنبال نکنند.
- دستور nosnippet: از نمایش توضیحات متنی یا پیشنمایش ویدیو در نتایج سرچ جلوگیری میکند.
- دستور max-snippet: حداکثر تعداد کاراکتر مجاز برای نمایش در اسنیپت متنی نتایج را تعیین میکند.
- دستور notranslate: به موتور جستجو اعلام میکند پیشنهاد ترجمه خودکار صفحه را به کاربران ارائه ندهد.
- دستور noarchive: مانع از ذخیره نسخه کششده (Cached) صفحه در سرورهای گوگل میشود.
فاز سوم: رتبهبندی (Ranking) و هوش مصنوعی موتور جستجو
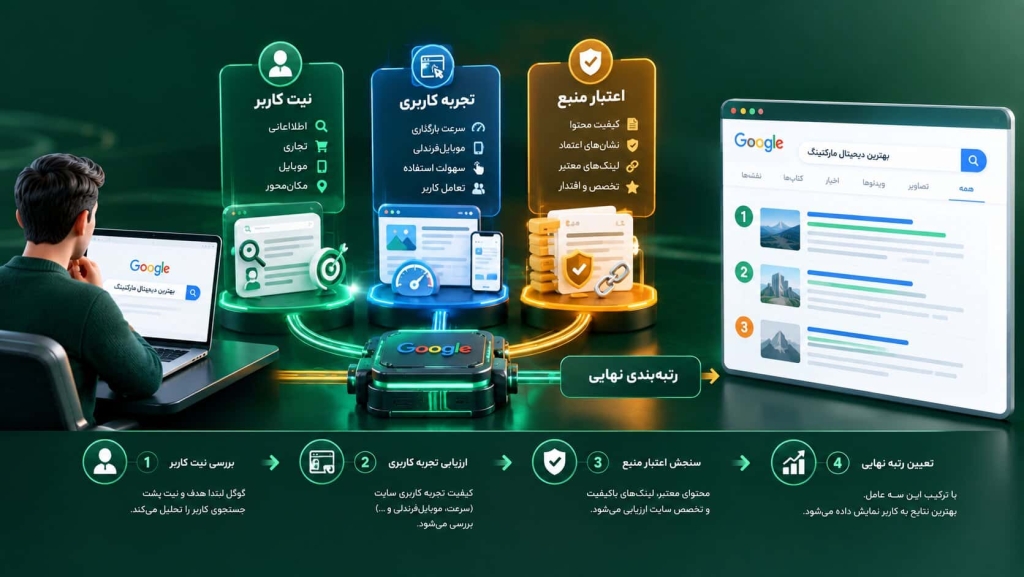
سومین و حساسترین گام، رتبهبندی نتایج در لحظه جستجوی کاربر است. هنگامی که پرسشی ثبت میشود، موتور جستجو نمایه معکوس را فراخوانی کرده و از میان هزاران سندی که کلمات مرتبط را شامل میشوند، مرتبطترین صفحات را استخراج میکند. سپس الگوریتمها بر اساس صدها سیگنال ارزیابی، خروجی را مرتب میسازند.
معیار بنیادین در این فرآیند، تطابق با نیت جستجو است. اگر کاربری به دنبال خرید یک کالا است، صفحهای با جدول مشخصات و دکمه پرداخت بالاتر از یک مقاله تاریخی درباره آن کالا قرار میگیرد. در نقطه مقابل، برای پرسشهای اطلاعاتی، راهنماهای عمیق و گامبهگام اولویت پیدا میکنند. اجرای منسجم این فرآیند نیازمند برنامهریزی دقیق است؛ از این رو تسلط بر استانداردهای مراحل انجام سئو سایت سبب میشود ساختار صفحات دقیقاً با انتظارات الگوریتمهای مرتبسازی همگام گردد.
نقش نیت جستجو (Search Intent) در جلب رضایت کاربر
موتور جستجو پرسشهای ورودی را بر مبنای قصد واقعی کاربر به چهار رده تفکیک میکند:
- نیت اطلاعاتی (Informational): کاربر در پی کسب دانش یا حل یک مشکل است (نظیر: نحوه کار موتور جستجو).
- نیت ناوبری (Navigational): کاربر قصد دارد به وبسایت یا صفحهای مشخص وارد شود (نظیر: ورود به سرچ کنسول).
- نیت بررسی تجاری (Commercial Investigation): کاربر در حال مقایسه مدلها، ویژگیها و قیمتها پیش از خرید است.
- نیت تراکنشی (Transactional): کاربر آماده اقدام نهایی و ثبت سفارش خدمات است.
تولید محتوایی که نیاز کاربر را به شکلی جامع برطرف نکند، معمولاً باعث میشود مخاطب مجدداً به صفحه نتایج بازگردد و گزینههای دیگر را بررسی کند. گرچه بازگشت سریع به صفحه نتایج به عنوان سیگنال قطعی رتبهبندی اعلام نشده، اما رضایت عمیق کاربر و پاسخگویی دقیق به نیت جستجو، هسته اصلی سامانههای یادگیری ماشین گوگل به شمار میرود.
سیستمهای هوش مصنوعی نوین در هسته الگوریتمهای گوگل
گوگل برای درک عمیق زبان و مفاهیم فراتر از تطابق واژگان، از چندین سیستم یادگیری ماشین بهره میگیرد:
- سامانه RankBrain: سیستم یادگیری ماشینی که کلمات کلیدی نادیده و عبارات مبهم را بر اساس الگوهای گذشته تحلیل و ترجمه میکند.
- مدلهای زبانی پیشرفته BERT: مدل پردازش زبان طبیعی که پیوند میان واژهها، ضمایر و حروف اضافه را در بستر جمله درک میکند.
- فناوری پیشرفته MUM: سامانه پردازش چندرسانهای که توانایی ادراک متن، تصویر و ویدیو را به طور همزمان داراست و پاسخ پرسشهای چندوجهی را ترکیب میکند.
- سیستم محتوای مفید (Helpful Content System): ناظر خودکاری که محتواهای تولیدشده صرفاً برای فریب موتورهای جستجو را بیارزش کرده و پاداش رتبه را به تجربیات انسانمحور اختصاص میدهد.
جدول مقایسهای سه فاز خزش، ایندکس و رتبهبندی
برای ایجاد دیدگاهی یکپارچه و مقایسهای از تفاوتهای زیرساختی، جدول زیر کارکرد هر یک از این سه مرحله را به تصویر میکشد:
| مرحله پردازش | عملکرد اصلی سیستم | ابزارها و نشانههای کلیدی | عامل اصلی چالش در این مرحله |
|---|---|---|---|
| خزش (Crawling) | کشف پیوندها و دانلود فایلهای صفحات | فایل Robots.txt، نقشه سایت XML، بودجه خزش | مسدودسازی سهوی در هاست، ریدایرکتهای طولانی، سرعت پایین سرور |
| نمایهسازی (Indexing) | رندر، درک متن و ذخیره در دیتابیس معکوس | تگ Canonical، متاتگ Robots، نشانهگذاری اسکیما | محتوای بسیار کم و تکراری، وابستگی شدید به جاوااسکریپت کلاینت |
| رتبهبندی (Ranking) | انتخاب مناسبترین پاسخ برای هر سرچ | الگوریتمهای هوش مصنوعی، اعتبار لینکها، نیت جستجو | عدم تطابق با نیاز کاربر، تجربه کاربری ضعیف و فقدان استانداردهای E-E-A-T |
تحلیل لاگ سرور (Log File Analysis)؛ مشاهده ردپای واقعی خزندهها
تحلیل فایل لاگ سرور یکی از دقیقترین روشهای ارزیابی خزش فنی به شمار میآید. فایل لاگ سرور وب شامل رکوردهای معتبری است که نشان میدهد در هر تاریخ و ساعت، کدام آیپی و چه رباتی درخواست دریافت صفحه را ثبت کرده است. با بررسی لاگ سرور مشخص میشود که آیا گوگلبات بیشتر وقت خود را صرف صفحات منقضیشده و تصاویر قدیمی میکند یا روی مقالات و دستهبندیهای تجاری تمرکز دارد.
ابزارهای تحلیل لاگ به مدیران سایت اجازه میدهند نرخ خطاهای پنهان سرور (مانند کدهای ۵۰۰ موقت که در سرچ کنسول ثبت نشدهاند) و زمانهای افت سرعت پاسخ سرور (Time to First Byte) را به وضوح رصد کرده و گلوگاههای زیرساختی را مرتفع سازند.
بهینهسازی معماری فنی سایت برای تسریع فرآیند ایندکس
برای آنکه اطمینان یابید رباتهای موتور جستجو بدون مواجهه با موانع فنی صفحات ارزشمند شما را خزش و ایندکس میکنند، پیادهسازی اصول زیر ضروری است:
- حذف صفحات یتیم (Orphan Pages): تمام صفحات تجاری و آموزشی باید از طریق منوها یا دستهبندیها لینک ورودی دریافت کرده باشند تا در جریان خزش قرار گیرند.
- کاهش عمق کلیک به زیر سه مرحله: هیچ صفحه باارزشی نباید با بیش از ۳ کلیک از صفحه اصلی فاصله داشته باشد تا اعتبار لینک به آسانی منتقل شود.
- پایش دائمی گزارش سرچ کنسول: بررسی مداوم وضعیتهای نمایهسازی و اعتبارسنجی مجدد پس از اصلاح ایرادات.
- بهبود سرعت لود و زمان پاسخ اولیه سرور: استفاده از لایههای کش پیشرفته و شبکههای توزیع محتوا برای تسهیل دانلود فایلها توسط خزندهها.
اجرای اصولی و مهندسیشده این چکلیست زیرساختی نیازمند تخصص فنی چندلایه است. بهرهگیری از توانمندیهای نوین در بخش خدمات سئو مسیر شما را در رفع چالشهای تکنیکال، تسریع خزش و کسب رتبههای درخشان هموار میسازد.
نتیجهگیری و توصیههای راهبردی
عملکرد موتورهای جستجو یک فرآیند منسجم و مبتنی بر نظم مهندسی است؛ هر صفحه برای درخشش در نتایج باید ابتدا به درستی خزش شود، موانع ایندکس آن برطرف گردد و ساختار آن مطابق با استانداردهای رتبهبندی بهینهسازی شود. اتکا به تولید انبوه مقالات بدون مهندسی زیرساخت خزش، صرفاً انباشت هزینهها را به همراه خواهد داشت.
با پیادهسازی معماری تمیز، ارتقای سرعت زیرساخت و ارائه محتوای تجربی که رضایت کاربران را برآورده سازد، خزندهها سایت شما را به عنوان مرجعی معتبر ثبت خواهند کرد. برای تحلیل کامل وضعیت خزش، تدوین نقشه راه ایندکس و رفع موانع فنی پلتفرم خود، همراهی متخصصان باسابقه آژانس دیجیتال مارکتینگ ترافیک به بهبود رتبهها و ارتقای اصولی ترافیک ارگانیک سازمان شما کمک میکند.
پرسشهای متداول درباره نحوه کار موتور جستجو
تفاوت اصلی خزش (Crawling) با نمایهسازی (Indexing) چیست؟
خزش به معنای کشف، دانلود و بررسی صفحات وب توسط رباتهای خودکار است، در حالی که نمایهسازی مرحله تجزیه، تحلیل و ذخیره اطلاعات آن صفحات در پایگاه داده اصلی موتور جستجو برای نمایش در نتایج است.
چقدر زمان میبرد تا یک صفحه جدید در گوگل ایندکس شود؟
بسته به اعتبار دامنه، بهینهسازی بودجه خزش و استفاده از ابزارهایی مانند سرچ کنسول، ایندکس یک صفحه میتواند از چند دقیقه تا چند روز یا در سایتهای ضعیف تا چند هفته به طول بینجامد.
آیا ثبت صفحه در نقشه سایت (Sitemap) به معنی ایندکس قطعی آن است؟
خیر؛ نقشه سایت صرفاً به عنوان یک راهنما به رباتها در کشف سریعتر آدرس کمک میکند، اما تصمیم نهایی برای ذخیره در پایگاه داده بر اساس کیفیت محتوا و ارزش آن برای کاربر گرفته میشود.
معنای وضعیت Crawled – currently not indexed در سرچ کنسول چیست؟
این وضعیت نشان میدهد که گوگل صفحه را خزش کرده اما تصمیم گرفته فعلاً آن را وارد نمایه نکند؛ موضوعی که معمولاً به دلیل ارزش محتوایی ناکافی یا شباهت با سایر صفحات رخ میدهد.
گوگلبات حداکثر تا چند مرحله ریدایرکت را دنبال میکند؟
طبق مستندات رسمی Google Search Central، خزندههای گوگل برای صفحات وب حداکثر تا ۱۰ مرحله ریدایرکت متوالی را دنبال میکنند و پس از آن با خطای انتقال متوقف میشوند، در حالی که این آستانه برای فایل robots.txt حداکثر ۵ مرحله است.